capulus-core
Quelle: pkr-lab/pkr-lab-docs/capulus/capulus-core/index.md






Vollständig automatisierter, GitOps-getriebener Home-Server mit drei getrennten Clustern.
Ansible liefert gehärtete Ubuntu-Hosts, drei schlanke Kubernetes-Cluster (k3s: TECH, PROD, ENTW), Continuous Delivery aus Git (ArgoCD) und Zero-Config-Remote-Access (Tailscale). Neue Versionen laufen erst auf ENTW und wandern nach bestandenem Gesundheits-Gate automatisch als PR nach TECH und PROD.
Zweck
capulus-core ist das GitOps-Repository des Capulus-Homelabs: Es enthält alle ArgoCD-Applications (Helm-Charts und Manifeste) für die Cluster TECH, PROD und ENTW, die Bootstrap-Konfiguration von ArgoCD, die Promotion-Kette ENTW → TECH → PROD, das Token-Register und die Hilfsskripte (Versiegeln, Promotion, Checks). Ein Merge nach main rollt auf TECH und PROD aus.
Die Hosts und Cluster selbst provisioniert capulus-ansible, die iOS-App liegt in capulus-ios. Beide Repos werden von capulus-core aus nur über Tags und veröffentlichte Dateien referenziert, nie über relative Pfade.
Was du bekommst
| Schicht | Komponente | Hinweis |
|---|---|---|
| Betriebssystem | Ubuntu Server 26.04 LTS | Gehärtet, UFW-Firewall, CrowdSec, NTP-synced, Swap off |
| Kubernetes | k3s (Kanal stable) | Drei Cluster: TECH (bare metal), PROD und ENTW (KVM-VMs); Traefik, CoreDNS, local-path, metrics-server |
| Virtualisierung | KVM/libvirt | PROD-VM auf dem Homeserver, ENTW-VM auf worker-1, Bridge-Netz direkt im LAN |
| GitOps | ArgoCD + ApplicationSets | Ein Hub für TECH + PROD, eine eigene Instanz für ENTW. Ordner unter argocd/apps/<cluster>/ anlegen → mergen → deployed |
| Promotion | GitHub Actions | Version läuft erst auf ENTW (24 h), dann TECH (2 h), dann PROD — jeweils als PR mit Gesundheits-Gate |
| Identität | lldap | Nutzer im LDAP-Verzeichnis |
| Split-DNS | dnsmasq auf tailscale0 | *.homeserver aus LAN und Tailnet auflösbar, verteilt auf TECH, PROD und ENTW |
| Werbeblocking | Pi-hole | Filtert DNS-Anfragen für alle Geräte, die dnsmasq bereits als DNS nutzen — kein Router-Eingriff nötig |
| Web-Ansible | Semaphore UI | Ein-Klick-git pull && ansible-playbook gegen das eigene LAN |
| Monitoring & Logs | VictoriaMetrics + Grafana + VictoriaLogs | Single-Node TSDB, vmagent, vmalert, Alertmanager, Hardware-Dashboards, zentrale Logs |
| Kubernetes-UI | Headlamp | Browser-Dashboard für den TECH-Cluster |
| Secrets | Sealed Secrets + kubeseal-webgui | Verschlüsselte Secrets in Git, je Cluster nur dort entschlüsselbar |
| Internes TLS | cert-manager | Eigene Root-CA, HTTPS auf *.tech/*.prod.homeserver |
| Notifications | ntfy | Self-hosted Push — ntfy (iOS + Android) |
| Live-Streaming | MediaMTX | RTMP/RTSP-Ingest → HLS-Playback; Publish/Zuschauer per interner mediamtx-Auth (Nutzername/Passwort) |
| Speicher | UGREEN NAS (NFS) | RAID1, StorageClasses nas und immich-nas für alle Cluster, restic-Backup auf USB-Platte |
| Remote-Access | Tailscale | WireGuard-Mesh-VPN — keine Portfreigaben, keine öffentliche IP |
| Externe Erreichbarkeit | Cloudflare Tunnel | Je Cluster ein Tunnel: ausgewählte Dienste öffentlich erreichbar, ohne VPN und ohne offene Ports |
| CI/CD intern | Argo Workflows + Garage | Private CI/CD-Pipeline + S3-Artifact-Store im Cluster |
| Ingress | Traefik (k3s bundled) | HTTP/HTTPS-Routing, je Cluster eine eigene Instanz |
| Provisioning | Ansible (≥ 2.14) | Vollständig idempotent, Role-per-Concern, Vault für Secrets |
Ziel-Hardware (nur TECH): kleine Box mit ≥ 4 GB RAM und ≥ 20 GB Disk.
Referenz-Build: HP ProBook 450 G9 (12 vCPU, ~61 GB RAM) als 24/7-Homeserver und Hypervisor, zwei per Wake-on-LAN
geweckte Worker (Lenovo M90q, MSI Tower), ein UGREEN NAS. Die Größen der VMs stehen unter Drei Cluster.
Auto-Upgrade-Details
auto_upgrade: true (Default) hält bei jedem Playbook-Run den gesamten Stack aktuell:
| Komponente | Mechanismus |
|---|---|
| APT-Pakete | apt dist-upgrade + unattended-upgrades für tägliche Sicherheits-Patches |
| Tailscale | state: latest für das tailscale-Paket |
| k3s | Folgt k3s_channel (Default stable), pin via k3s_version |
| Helm | Re-Run des offiziellen Installers bei neuem Release |
| ArgoCD | helm upgrade --install ohne --version, pin via argocd_version |
| Reboot | Auto-Reboot wenn APT /var/run/reboot-required setzt (togglebar via auto_reboot_if_required) |
Für reproduzierbare Builds: auto_upgrade: false in ansible/group_vars/all.yml.
Drei Cluster
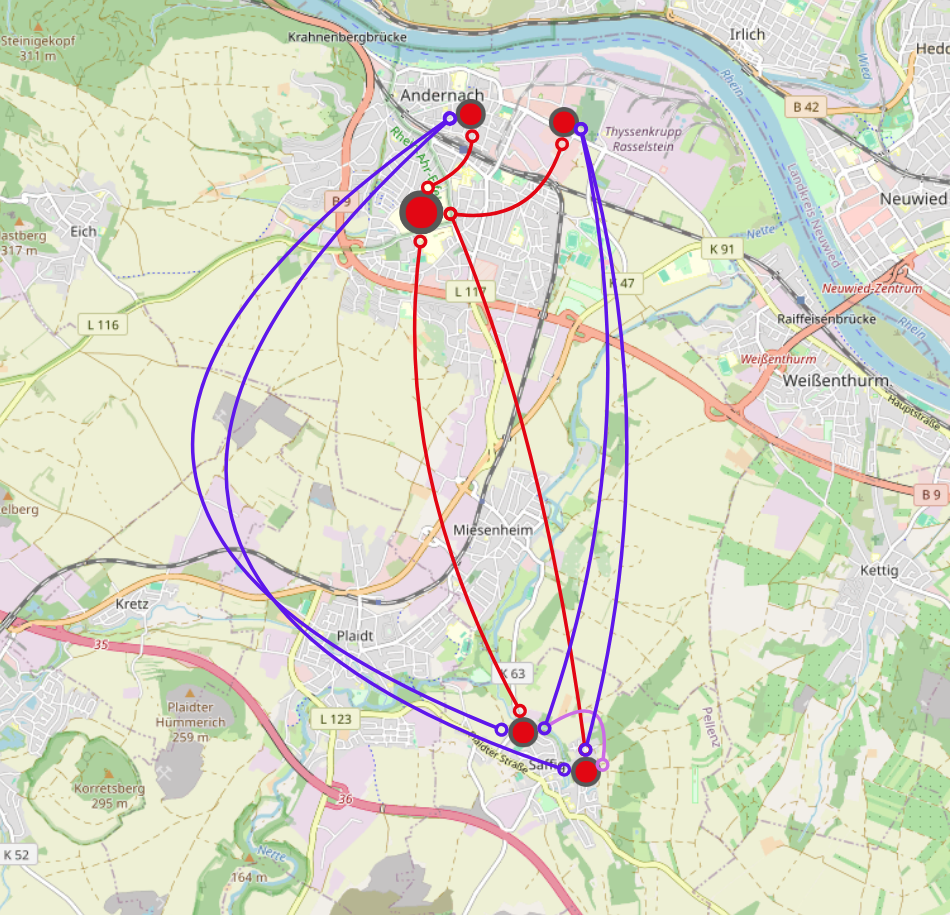
Standortübersicht der Cluster-Knoten — wird später um das Standby-HA-Paar mit den Pis erweitert (siehe 40090).
Der Stack besteht seit September 2026 aus drei getrennten k3s-Clustern
(Architektur und Begründung,
Überblick):
| Cluster | Läuft auf | IP | Für | ArgoCD | Ordner |
|---|---|---|---|---|---|
| TECH | homeserver (bare metal, 24/7) + Worker worker-0/worker-1 |
192.168.178.94 |
Infrastruktur und Betriebsdienste: Identität, Secrets, Monitoring, CI/CD, DNS, Zammad, Vaultwarden, n8n | Hub, verwaltet TECH und PROD | argocd/apps/tech/ |
| PROD | KVM-VM prod-vm auf dem Homeserver (6 vCPU / 24 GiB) |
192.168.178.99 |
Apps mit echtem Nutzerkreis: Nextcloud, Immich, Paperless-ngx, Wiki.js, Xibo | — (vom Hub verwaltet) | argocd/apps/prod/ |
| ENTW | KVM-VM entw-vm auf worker-1 (3 vCPU / 12 GiB) |
192.168.178.100 |
Entwicklung und Tests, absichtlich verwundbare Trainingsumgebung | eigene, isolierte Instanz (Branch entw) |
argocd/apps/entw/ |
Branch entw ──► ArgoCD ENTW ──► ENTW-Cluster
                    │  (24 h gesund, Smoke-Checks)
                    ▼
Branch main ──► ArgoCD-Hub ──► TECH-Cluster   (Promotion-PR, Auto-Merge optional)
                    │  (2 h gesund)
                    ▼
                 ArgoCD-Hub ──► PROD-Cluster  (Promotion-PR, du bestätigst)
Ein Hostname wie
n8n.prod.homeserversagt nur etwas über das Tier, nicht über den Cluster: welcher
Cluster antwortet, entscheidet das DNS (c0040).
kubectl-Befehle in den App-Docs gelten für den Cluster, in dem die App läuft
(Zugriff je Cluster).
Der Aufbau der Cluster steht in installation.md.
Repository-Landschaft
flowchart LR
  subgraph Quellen
    ansible["capulus-ansible<br/>Hosts, k3s, Kiosks"]
    core["capulus-core<br/>ArgoCD-Apps, Promotion"]
    ios["capulus-ios<br/>SwiftUI-App"]
    docs["pkr-lab-docs<br/>Dokumentation"]
    sync["capulus-wiki-sync<br/>Docs → Wiki.js"]
  end
  docs -->|"Tarball"| sync
  sync -->|"Image, Tag per Renovate"| core
  ansible -->|"rendert argocd/bootstrap/"| core
  core -->|"Tag + SHA-256: alert-caller"| ansible
  core -->|"pki/ Root-CA"| ansible
  core -->|"pki/ Root-CA"| ios
  ios -->|"HTTPS-API"| carplay["carplay-api in capulus-core"]
  ansible -->|"provisioniert"| cluster["Hosts und k3s-Cluster"]
  core -->|"ArgoCD synct"| cluster
| Repo | Inhalt | Verbindung zu capulus-core |
|---|---|---|
| capulus-core | ArgoCD-Apps, Bootstrap, Promotion, Skripte, Token-Register, Root-CA unter pki/ |
– |
| capulus-ansible | Playbooks und Rollen für Hosts, k3s, Kiosks | rendert argocd/bootstrap/ (make render-bootstrap CORE_DIR=…), lädt alert-caller-Quellen aus einem core-Tag |
| capulus-ios | SwiftUI-App „Homeserver Dashboard“ | spricht die API von carplay-api an, trägt eine Kopie der Root-CA |
| pkr-lab-docs | diese Dokumentation | – |
| capulus-wiki-sync | Code des Wiki-Syncs (Docs → Wiki.js) | läuft als Image im Chart argocd/apps/prod/wiki-docs-sync, siehe wiki-sync |
Repository-Layout
capulus-core/
├── README.md                         # Kurzfassung mit Link zur Doku
├── CLAUDE.md                         # Arbeitsregeln für KI-Assistenten
├── Makefile                          # help, lint
├── renovate.json                     # Renovate-Konfiguration
├── CHANGELOG.md                      # von semantic-release geschrieben
├── .github/
│   ├── dependabot.yml
│   └── workflows/                    # ci, codeql, build-images, release, renovate, promote-*, sync-entw, mirror-gitlab, …
├── pki/                              # homeserver-root-ca.pem
├── ops/token-register.yaml           # Register aller Tokens und Passwörter
├── scripts/                          # promote-chain.py, sync-entw.sh, reseal-for-prod.sh, seal-*.sh, token-watch.py, …
└── argocd/
    ├── promotion.yaml                # Gates und Smoke-Checks der Promotion-Kette
    ├── bootstrap/                    # TECH-Hub (GENERIERT durch capulus-ansible)
    ├── bootstrap-prod/               # PROD im Hub (handgeschrieben)
    ├── pending/                      # vorbereitete, noch nicht ausgerollte Apps
    └── apps/
        ├── tech/                     # Projekt "tech"
        ├── prod/                     # Projekt "prod", vom TECH-Hub synchronisiert
        └── entw/                     # Projekt "entw", ENTW-ArgoCD liest den Branch entw
Die Apps je Cluster stehen in capulus-core/b-kubernetes-gitops/b0020-argocd-projects.md, die Ansible-Rollen in capulus-ansible.
Dokumentation
Alle Docs von capulus-core liegen in diesem Ordner, sortiert in Kategorie-Unterordner; Docs, die vor allem Host-Provisionierung betreffen, liegen unter capulus-ansible. Jede
Datei trägt eine 5-stellige Hex-ID (erstes Zeichen = Kategorie) — Details
und Konventionen für neue Docs: capulus-core/TEMPLATE.md.
Neu hier? Der beste Einstieg ist der Architektur-Überblick.
Betriebssystem & Grundlagen (a-betriebssystem/)
| Dokument | Inhalt |
|---|---|
| Ubuntu-Server-Installation | ISO, USB-Stick, Installer, erster Boot |
| Architektur-Überblick | Drei Cluster, Schichten, Traffic-Flows, App-Matrix, Ansible-Rollen |
| Voraussetzungen | Was vor dem Ansible-Run nötig ist |
| Installationsleitfaden | Vollständiger Step-by-Step-Walkthrough |
| Troubleshooting | Diagnose-Playbook für häufige Probleme |
Kubernetes & GitOps (b-kubernetes-gitops/)
| Dokument | Inhalt |
|---|---|
| k3s-Referenz | Config, kubectl-Cheatsheet, Upgrades |
| ArgoCD-GitOps | Hub und ENTW-Instanz, App-Workflow je Cluster, CLI, Sync-Policies |
| ArgoCD-Projects | Ein Projekt je Cluster (tech/prod/entw), ApplicationSets, neue App hinzufügen |
| Semaphore-UI | Web-UI zum Ausführen von Playbooks |
| Autoskalierung (HPA) | Welche Apps per HorizontalPodAutoscaler mitskalieren, welche bewusst nicht, und mit welchen Schwellenwerten |
| ENTW-ArgoCD | Eigene ArgoCD-Instanz für ENTW, liest nur argocd/apps/entw/; neue App deployen, Rollout, Zugriff |
| MetalLB | LoadBalancer-Adresse 192.168.178.200 für Traefik: von Hand installiert, Ist-Zustand, Neuaufbau, Auffälligkeiten |
| Sealed Secrets | Controller, Secrets versiegeln, Schlüssel sichern, Fehlersuche |
| Traefik-Konfiguration | HTTP→HTTPS-Weiterleitung, Metriken, Standard-Zertifikat (TLSStore) |
| Beispiel-Apps | demo-app (Self-Heal-Demo) und example-whoami auf ENTW und PROD |
Netzwerk & DNS (c-netzwerk-dns/)
| Dokument | Inhalt |
|---|---|
| DNS-Architektur | Warum der Home-Server NICHT dein LAN-DNS ist |
| Tailscale-VPN | Auth-Keys, MagicDNS, Subnet-Routes |
| WireGuard-Backup | Notfall-Tunnel für den Fall, dass die Tailscale-Control-Plane ausfällt |
| Pi-hole | Netzwerkweites Werbeblocking als DNS-Filter vor der Fritz!Box — kein Router-Eingriff nötig |
| Port-Übersicht | Interner Service-Port, LAN- und externe Erreichbarkeit für jede App |
| Domain-Tiers | dev/tech/prod-URL-Konvention (app.tier.homeserver), Tier vs. Cluster im DNS, externe Hosts, Cross-App-Referenzen |
| CoreDNS-Erweiterung | *.homeserver im Cluster auflösen: Weiterleitung an dnsmasq |
Sicherheit (d-sicherheit/)
| Dokument | Inhalt |
|---|---|
| Incident-Report 12.08.2026 | Postmortem: ApplicationSet-Migration löschte versehentlich 32 Apps, Ursache + Gegenmaßnahmen |
| Security-Härtung — Roadmap | Phasenplan der Security-Härtung nach dem Incident vom 12.08.2026 |
| CrowdSec | Brute-Force-Schutz für SSH und Traefik, Firewall-Bouncer, Whitelist für LAN/Tailnet |
| Cluster-NetworkPolicies | NetworkPolicies je Namespace, Default-Deny + explizite Ausnahmen (Härtung Phase 3) |
| Internes TLS | cert-manager + eigene CA für HTTPS auf *.homeserver, PROD mit eigener Intermediate-CA (Härtung Phase 5) |
| Secrets-Encryption + Audit-Log | k3s Secrets-at-Rest-Verschlüsselung + API-Audit-Log (Härtung Phase 4) |
| Secrets-Rotation-Checkliste | Checkliste zur regelmäßigen Rotation aller Cluster-Secrets (Härtung Phase 7) |
| lldap | Nutzer- und Gruppenverwaltung (LDAP) |
| CodeQL, Dependabot, Security-Issues | Code-Scanning, Fix-PRs für verwundbare Abhängigkeiten, automatische Security-Issues, Vergleich mit Open-Source-Alternativen (Härtung Phase 10) |
Externe Erreichbarkeit (e-externe-erreichbarkeit/)
| Dokument | Inhalt |
|---|---|
| Cloudflare Tunnel — Setup | Externe Erreichbarkeit ohne VPN: Konzept, zwei Tunnel (TECH/PROD), Tunnel-Einrichtung, Absicherung |
| Cloudflare Tunnel — Deploy | Rollout, neuen Dienst freigeben, Rotation, Troubleshooting |
CI/CD & Automatisierung (f-cicd-automatisierung/)
| Dokument | Inhalt |
|---|---|
| Argo Workflows | Private CI/CD-Pipeline mit Garage-Artifact-Store |
| Renovate | Automatische Update-PRs für Helm-Chart-Versionen und Image-Tags (Sicherheits-PRs kommen von Dependabot) |
| Release-Automatisierung | GitHub Release + Changelog bei jedem Merge auf main via semantic-release |
| GitHub Release Watcher | Neue GitHub-Releases erkennen und per Zammad-Ticket eine E-Mail-Benachrichtigung auslösen |
| GitLab-Mirror | Vollspiegelung (alle Branches + Tags) zu GitLab als Redundanz für den Fall eines GitHub-Ausfalls |
| Workload-Images bauen | Eigene Workload-Images per GitHub Actions nach GHCR bauen (auf PRs als Probebuild) |
| CI-Pflicht-Gate | make lint, kubeconform (Charts, Manifeste, Bootstrap), Go-Check und gitleaks auf jedem PR |
| ENTW → main Promotion | Neue entw-Commits nach grüner CI als PR an main, main → entw per Sync-Workflow, Rulesets |
Branch-Schutz main |
Ruleset: main nur per Pull Request, vier CI-Jobs als Pflicht-Checks, Admin-Notausgang |
| Tailscale-Runner-PoC | Diagnose: GitHub-Runner erreicht Hub- und ENTW-ArgoCD über Tailscale |
| Promotion-Kette | Versionen ENTW → TECH → PROD als PRs nach bestandenem Gesundheits-Gate (24 h ENTW, 2 h TECH), Smoke-Checks |
| Skripte und Workflows: Referenz | alle 20 Skripte und 15 Workflows mit Aufruf, Umgebung, Meldungen und Fehlerbildern |
Benachrichtigungen (1-benachrichtigungen/)
| Dokument | Inhalt |
|---|---|
| ntfy iOS-Push | Self-hosted ntfy mit iOS APNs-Relay |
| Telefon-Alarm | Anruf mit deutscher Sprachansage bei schweren Ausfällen (SIP über Linphone, baresip, Piper). Läuft als Pod in TECH, eine externe VM (Ansible-Rolle) ist vorbereitet |
| ntfy-bridge | Alertmanager-Webhook → ntfy: Ablauf, Prioritäten, Fehlersuche |
Betrieb & Hardware (2-betrieb-hardware/)
| Dokument | Inhalt |
|---|---|
| NAS-Storage | NFS-StorageClass gegen die UGREEN NAS (RAID1), Migration einzelner Apps von local-path |
| NAS-Backup | Externe USB-Platte am NAS: regelmäßige restic-Backups von volume1 + volume2 |
| Cluster Power Manager | worker-0/worker-1 per Wake-on-LAN je nach Homeserver-Last automatisch dazu- und wieder abschalten |
| Nightly Worker Update | worker-0/worker-1 nachts um 01:00 Uhr per Wake-on-LAN wecken, apt-Update fahren (max. 20 Min.), wieder herunterfahren |
| Drucker (CUPS) | Samsung Xpress M2026 per USB am Homeserver, Freigabe im Heimnetz + Tailnet via IPP/AirPrint |
| GitOps- und Backup-Alerts | Alerts auf ArgoCD-Gesundheit (Degraded, OutOfSync, hängender Sync) und auf CronJobs/Backups ohne Erfolg der letzten 30–36 h |
| Hardware-Monitoring | Grafana-Ordner "Hardware": Waben-Übersicht aller Server/VMs/NAS, Server-Detail (CPU, RAM, Netzwerk, Disk, Temp), Füllstand + S.M.A.R.T. |
| Zentrale Fehlersuche | Einstieg für alle Störungen: Symptom → richtige Anleitung, die ersten fünf Minuten, Übersicht aller Fehlersuche-Abschnitte |
Apps & Workloads (3-apps-workloads/)
Die Spalte Cluster zeigt, wo die App läuft (Ordner unter argocd/apps/).
| Dokument | Cluster | Inhalt |
|---|---|---|
| Zammad | TECH | Helpdesk-/Ticket-System, u. a. Ziel für github-release-watcher-Benachrichtigungen |
| Alarmmonitor-Kiosks | TECH | Raspberry-Pi-Kiosks für ALAMOS AMweb, zentral verwaltet |
| Vereinsheim-Alarmmonitor | TECH | Banana-Pi-Kiosk fürs Vereinsheim, Alarmstatus-Anzeige + Heartbeat-Monitoring |
| Vereinsheim-Windows-PC | — | Windows-PC am Standort: Online-Check und Herunterfahren |
| Wiki.js | PROD | Team-Wiki, die Doku wird per wiki-docs-sync automatisch gespiegelt |
| MediaMTX Live-Streaming | TECH | RTMP/RTSP-Ingest → HLS, Publish- und Zuschauer-Autorisierung über mediamtx' eingebaute interne Benutzerverwaltung (HTTP Basic Auth) |
| Paperless-ngx | PROD | Dokumentenmanagement mit OCR — Briefe, Rechnungen, Verträge scannen und durchsuchen |
| n8n | TECH | Low-Code-Automatisierung — Dienste verknüpfen ohne Programmieren |
| Uptime Kuma | TECH | Status-Seite und Alerting für alle Dienste |
| Rhein-Dashboard | TECH | Grafana: Pegelonline, DWD-Warnungen, ELWIS, Hochwasservorhersage RLP |
| Vaultwarden | TECH | Bitwarden-kompatibler Passwort-Manager für Browser/Mobile-Clients |
| Nextcloud | PROD | Datei-Sync, Kalender, Kontakte |
| Immich | PROD | Foto-/Video-Backup vom Handy inkl. Gesichtserkennung, eigener NAS-Storage-Export |
| Homeserver-Dashboard-API | TECH | Go/Gin-API + power-agent für die reine iOS-App Homeserver Dashboard (Metriken, Alerts, Status, Helligkeit, Wake/Shutdown) |
| xibosignage | PROD | Xibo CMS + Bilder-Slideshow auf Raspberry Pi 3B+, n8n-Workflow für automatisches Einspielen |
| Infotafel-Kiosk | — | Raspberry-Pi-3-B+-Kiosk der Infotafel: Startablauf, Mauszeiger, lokaler Bilder-Cache |
| pacman — Besuchertracking | TECH | IP/GeoIP-Besucher-Tracking-Demo für die IT-Security-Schulung |
| Ollama | Desktop-PC | LLM auf dem Desktop-PC, per Wake-on-LAN geweckt (Aufruf aus n8n) |
| ALAMOS-Einsatzalarm → Zammad | TECH | n8n-Workflow: Einsatzalarm wird zum Zammad-Ticket |
| ALAMOS-Webhook-Relay | TECH | Öffentlicher Mini-Proxy vor n8n, damit ALAMOS den Einsatzalarm-Webhook erreicht, ohne n8n selbst öffentlich zu machen |
| ISC-News-Bot | TECH | News im DLRG ISC per API anlegen (Playwright-RPA), aufgerufen aus n8n, cluster-intern |
| Instagram-Post per Mail | TECH | n8n-Workflow: Mail mit JSON und Bildern wird zum Instagram-Beitrag (Graph API), Bilder kurz über einen einzelnen öffentlichen Pfad für Meta |
| ISC-Urkunden melden | TECH | n8n-Workflow + ISC-News-Bot: donnerstags 17:30–20:00 neue Seepferdchen-, Schwimmabzeichen- und Juniorretter-Urkunden per Mail |
| Zentrales Logging | TECH | VictoriaLogs: journald aller Hosts und Pod-Logs an einem Ort |
| Headlamp | TECH | Kubernetes-Dashboard im Browser, Anmeldung mit kurzlebigem Lese-Token |
| kubeseal-webgui | TECH | Secrets im Browser versiegeln (Zertifikat des TECH-Controllers) |
| Garage | TECH | S3-Speicher für Argo Workflows (Bucket argo-artifacts) |
| Monitoring | TECH | VictoriaMetrics, Grafana, Alertmanager, Regeln, Fehlersuche |
| ticket-gate | TECH | E-Mail-Bestätigung (6-stelliger Code) vor dem Ticketformular der Website, legt das Ticket erst danach in Zammad an |
| MDM für iPads | TECH | Eigener Apple-MDM-Server (NanoMDM, NanoDEP, SCEP) mit n8n-Automatisierung: Überblick, Installation, Apple-Setup, Automatisierung, Betrieb, Sicherheit |
Planung (4-planung/)
Pläne und Analysen. Ein Doc trägt in seiner Statuszeile, wie weit es umgesetzt ist.
| Dokument | Inhalt |
|---|---|
| Authelia-SSO | Ursprünglicher SSO-Plan mit Authelia, wieder abgelöst |
| Öffentliches Teilen ohne Gast-Accounts | Immich/Nextcloud: Teilen von Inhalten ohne Gast-Accounts |
| Vereinsheim WoL + Router-VPN | Wake-on-LAN am Standort Vereinsheim, Router-VPN als Fallback |
| GitLab + Proxmox — Prüfung | Analyse: GitLab self-hosted und Proxmox als Hypervisor |
| Zammad-Kalender → Nextcloud | Kalendereinladung aus Zammad über n8n nach Nextcloud und iOS |
| GitHub-Repos versionieren | Versionierung für alle GitHub-Repos |
| Einsatz-Alarm per E-Mail | E-Mail mit den wichtigsten Einsatzdaten |
| Multi-Cluster ENTW/PROD/TECH | Architektur und Umsetzungsplan der Drei-Cluster-Umstellung, Phasen und offene Punkte |
| Zwei Control-Planes im TECH-Cluster | Umstellung auf embedded etcd mit ControlPlane-0 und -1, ControlPlane-2 vorbereitet, Namensschema, Runbooks |
| Zammad-Chart 20 und neues Postgres | Upgrade 16.4 → 20.0.2, Dump/Restore von Bitnami-PG 17 nach PG 18, Auto-Sync-Pause, Rollback |
Incidents (5-incidents/)
| Dokument | Inhalt |
|---|---|
| NAS-Platte rot, homeserver unerreichbar | Vorfall vom 02.09.2026: Hypothese und Prüfschritte |
| PROD-VM startet nicht mehr, Basis-Image ausgetauscht | Vorfall vom 23.09.2026: Ursache, Behebung und Lehren |
| Pi-hole-Update legt DNS und Tunnel lahm | Vorfall vom 05.10.2026: DNS-Deadlock beim Image-Pull, Notfall-Ablauf und Umstellung auf RollingUpdate |
| Infotafel: altes Bildformat, keine neuen Bilder, Slides zu schnell übersprungen | Vorfall vom 22.10.2026: fehlendes EDID, Tailscale-Routing zum NAS, Race Condition beim Bilder-Sync |
| Kernel 7.0.0-42 verweigert Signale in Containern, Zammad-Datenbank startet nicht | Vorfall vom 05.11.2026: AppArmor verweigert Signale zwischen Prozessen eines Containers, Rollback auf Kernel 7.0.0-38, Prüfbefehle |
Hintergründe (6-hintergruende/)
Warum der Code so gebaut ist: Begründungen, Fallstricke und Vorfall-Regeln. Der Code selbst enthält keine Kommentare, was früher daneben stand, steht hier.
Einstieg und Zuordnung von Dateien zu Docs: capulus-core/6-hintergruende/60000-uebersicht.md.
| Dokument | Inhalt |
|---|---|
| Ansible: Hosts, VMs und Playbooks | ENTW-/PROD-VM, libvirt_host (Bridge, dnsmasq-Snippet, Basis-Image), DNS der VMs, Worker-Playbooks, WireGuard-Notzugang |
| Ansible: Rollen | Kiosk-Geräte, Energie-Rollen, Watchdogs, vmagent, journal_upload, Semaphore-Rollen |
| ArgoCD, Bootstrap und SealedSecrets | Bootstrap-Dateien, ignoreDifferences, PROD im Hub, Migrationen, Promotion-Konfiguration, Fallstricke beim Versiegeln |
| Helm-Charts im TECH-Cluster | Gemeinsame Muster, Zertifikate und TLS, Traefik-Metriken, alle TECH-Apps |
| Helm-Charts im PROD-Cluster | PROD-Kopien, Nextcloud, Immich, Wiki.js und wiki-docs-sync, Xibo, Paperless-ngx |
| Monitoring und Alerting | Alertmanager-Routing, VMRules, Scrapes und Labels, Grafana-Ordner, Logging |
| lldap | Chart-Entscheidungen und Secrets |
| carplay-api und iOS-App | Verträge, Absicherung, Datenquellen, Transport über Tailscale |
| pacman (Schulungsobjekt) | Server, Bestenliste, Trainingsmodus, Frontend-Skripte |
| CI-Workflows, Skripte und Lint | Workflows, Promotions- und Sync-Skripte, Ruleset, Dependabot/Renovate, Lint-Konfiguration |
| Nachprüfung nach der Repo-Aufspaltung | Befunde, Fixes, Testmatrix, Renovate und Rulesets, offene Entscheidungen |
| capulus-operator | Entscheidungen, Backup-Controller, Alerts, Chart und CI |
| MDM | Cloudflare und Geräte-Authentifizierung, SCEP-Image, Datenbank, NanoMDM-/NanoDEP-Fallstricke, n8n-Workflows |
Komponenten-Seiten (früher Ordner-READMEs): ENTW-Ordner (ENTW-Ordner),
PROD im Hub (PROD im Hub anbinden, Umzug mit Daten),
pacman, carplay-api,
capulus-ios (iOS-App).
MIT — siehe LICENSE · Made with ☕ & GitOps
Fehlersuche
Einstieg bei Störungen: Zentrale Fehlersuche. Jede App und jede Komponente hat in ihrer Doku einen Abschnitt „Fehlersuche“ (Meldungen, Ursachen, Lösungen). Skripte und Workflows: Referenz.